
Resumo: Memória longa em IA não é sobre “guardar mais”. É sobre decidir o que fica na superfície, o que afunda, o que consolida e, principalmente, quando esquecer de...
Memória longa em IA não é sobre “guardar mais”. É sobre decidir o que fica na superfície, o que afunda, o que consolida e, principalmente, quando esquecer de propósito.
O gargalo não é criar memória: é orquestrar
No CoreMind, o objetivo é construir um “cérebro” de IA com memória longa, múltiplas integrações e uma arquitetura preparada para lidar com muito mais contexto sem virar um caos. O ponto central do devlog é a virada de mentalidade: uma IA boa não precisa apenas de mais capacidade de lembrar; ela precisa de um sistema de gestão para que o volume de informações não degrade a utilidade.
Na prática, o problema aparece quando a memória cresce sem controle: a busca fica ruidosa, respostas tendem a puxar contexto irrelevante e o custo operacional aumenta. Em vez de “memória infinita”, o CoreMind trata memória como um conjunto de estados e processos, inspirado em rotinas de anotações e em discussões sobre o que deve ser esquecido (a referência citada no vídeo é “A Arte de Esquecer”, de Ivan Izquierdo).
Isso leva a um desenho onde memória não é um banco estático, mas um sistema vivo. Entre os componentes citados:
- Sinopses para manter visão resumida do que importa.
- Tags e mecanismos de relevância para organizar e reduzir ruído.
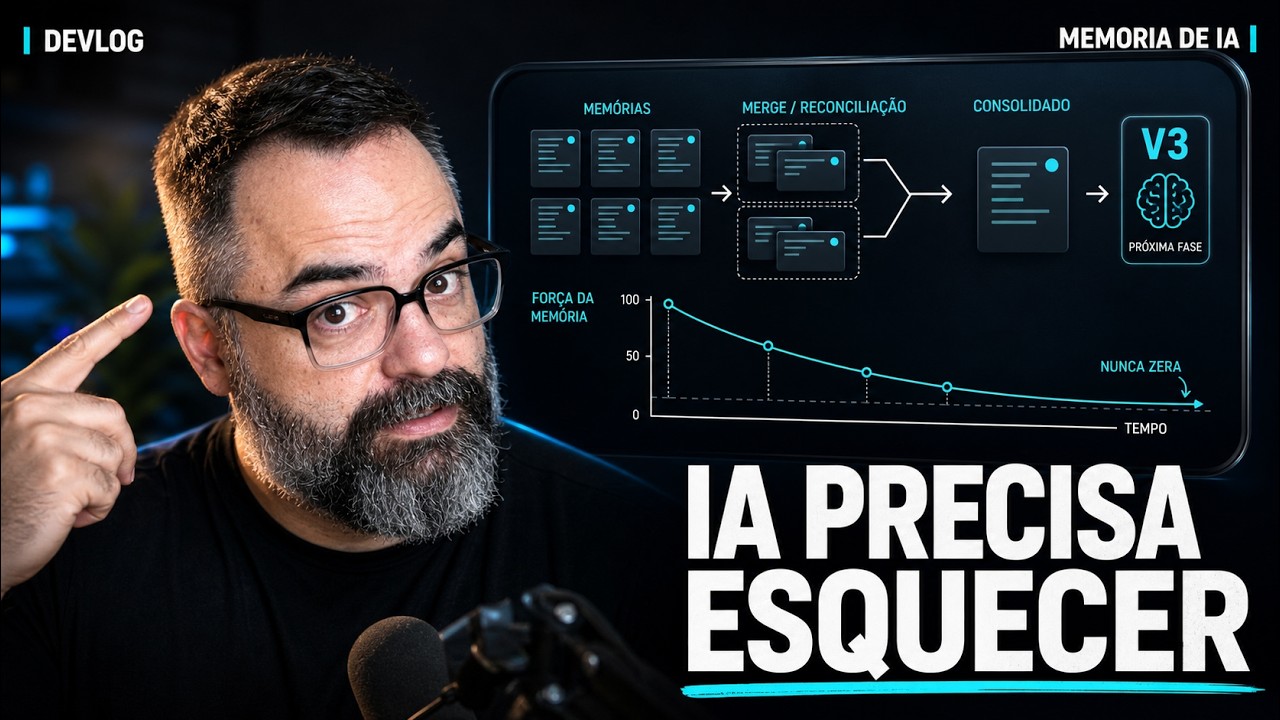
- Decaimento por desuso para que informações antigas percam prioridade.
- Piso emocional (não como “sentimento”, mas como um nível mínimo de preservação) para evitar que tudo zere e a memória útil desapareça cedo demais.
- Reconciliação de duplicatas e merge para combater bloat.
- Uma etapa de “sono” para consolidação, como um ciclo de processamento fora do fluxo direto da conversa.
O resultado esperado é uma memória que melhora com o tempo sem acumular lixo semântico.
“Esquecer” vira arquitetura: decaimento, relevância e piso que não zera
Um dos insights mais importantes é que memória longa precisa de mecanismos que não dependam apenas de “repetir” ou “buscar”. Se o sistema guarda tudo, ele inevitavelmente encontra o que não deveria voltar ao contexto.
O CoreMind implementa um modelo com:
- Decaimento: a memória perde força quando não é usada. Isso reduz a chance de conteúdos antigos continuarem competindo com conteúdos recentes e relevantes.
- Relevância: a recuperação prioriza o que tem maior aderência ao momento da consulta, e não apenas o que existe no vault.
- Piso emocional: mesmo com decaimento, existe um mínimo que impede que memórias valiosas “morram” cedo demais. A lógica descrita é menos sobre emoção e mais sobre um limiar de preservação para manter estabilidade.
Esse piso é crucial para sistemas corporativos e assistentes de longo prazo: sem ele, o comportamento pode ficar errático. Um usuário pode “perder” conhecimento que ele mesmo já forneceu, simplesmente porque o sistema não o acessou por tempo suficiente.
O vídeo também destaca um ponto prático: tirar embeddings “do centro da busca”. Em vez de tornar embeddings o mecanismo dominante, o sistema passa a incorporar ideias do material do Izquierdo para ajustar como a memória é consolidada e recuperada. Em termos de produto, isso costuma reduzir o efeito colateral de recuperar memórias semanticamente próximas, mas operacionalmente inadequadas.
Outro elemento ligado ao “esquecer” é a eliminação de duplicatas. O devlog descreve um bug anterior que gerava duplicação de memórias; agora o pipeline inclui candidatos, judge e merge, com limite de tamanho e anti-bloat. Não é só limpeza: é controle de qualidade do acervo.
Simplificação do reforço: menos coeficiente emocional, mais incrementos objetivos
Uma mudança importante na arquitetura é reduzir dependência de ponderações subjetivas feitas pela IA. Antes, a memória podia ser reforçada com base em sinais interpretados pela própria IA (como elogios ou críticas, convertidos em algum tipo de “coeficiente emocional”). No CoreMind, esse modelo foi simplificado para tornar o reforço mais previsível.
O princípio descrito é direto: se o usuário elogia ou critica uma resposta, isso reforça a memória de forma mais previsível, via incrementos objetivos. Em vez de deixar a IA “decidir o peso” de maneira mais interpretativa, o sistema transforma feedback em regras mais determinísticas.
Para operações B2B, esse tipo de previsibilidade importa por dois motivos:
- Comportamento auditável: fica mais fácil explicar por que uma memória foi consolidada ou enfraquecida.
- Menos variação entre execuções: o sistema tende a reagir de modo consistente ao mesmo tipo de feedback.
Na prática, o pipeline de consolidação descrito no vídeo envolve etapas como rascunhos, candidatos, um “judge” e o merge. Essa sequência ajuda a filtrar o que vira memória permanente, evitando que qualquer fragmento do chat vire conhecimento persistente.
O devlog também menciona que o modelo roda com 31 testes passando e zero duplicatas no vault nesse estágio. Para um projeto de memória longa, esses números são um sinal relevante: não é apenas “funciona”, é “funciona sem acumular inconsistências”.
Consolidação e próximos passos: “sono” agora, “esqueca isso” na V3
O CoreMind adiciona uma etapa de sono para consolidar memórias. Em vez de misturar tudo em tempo real, o sistema faz um ciclo separado de processamento, o que tende a melhorar a qualidade das sinopses e do merge, além de reduzir o impacto no fluxo de conversa.
No estado atual, o projeto já conta com:
- Pipeline de merge e limite de tamanho para evitar anti-bloat.
- Decaimento e rotinas de consolidação em execução.
- Correções para duplicatas (bug resolvido conforme relatado).
- Estrutura com duas áreas no “cérebro” para manter simplicidade e reduzir complexidade acidental.
A próxima etapa é a V3, com uma funcionalidade que muda a experiência do usuário e o controle do sistema: suprimir por pedido do usuário, o “famoso ‘esqueca isso’”.
Isso fecha o ciclo do argumento central do episódio: memória longa não é só retenção; é governança. Em um assistente corporativo, a capacidade de eliminar informação por solicitação é essencial para conformidade, privacidade e controle de qualidade do conhecimento do sistema.
O vídeo também indica que a fase seguinte envolve testes reais com LLM, saindo do ambiente de validação para medir desempenho em cenários mais próximos do uso efetivo. A promessa aqui é uma IA com memória mais útil, mais barata de operar e menos dependente de “guardar tudo o tempo todo”.
Se você quer ver como essas decisões viram código e pipeline (rascunhos, judge, merge, decay e o ciclo de sono), assista ao vídeo para mais detalhes.
Sua empresa pode ir mais longe com inteligência artificial.
Na Sincron IA, criamos soluções sob medida em automação e IA para empresas que querem liderar seus mercados.
Vamos conversar → sincronia.digital
Receba insights de automação e IA
Conteúdo exclusivo sobre automação empresarial, inteligência artificial e produtividade. Sem spam.

