
Resumo: Se o seu projeto de IA depende de RAG, embeddings e banco vetorial “porque todo mundo faz”, você pode estar pagando caro por complexidade que não agrega ao s...
Se o seu projeto de IA depende de RAG, embeddings e banco vetorial “porque todo mundo faz”, você pode estar pagando caro por complexidade que não agrega ao seu caso de uso.
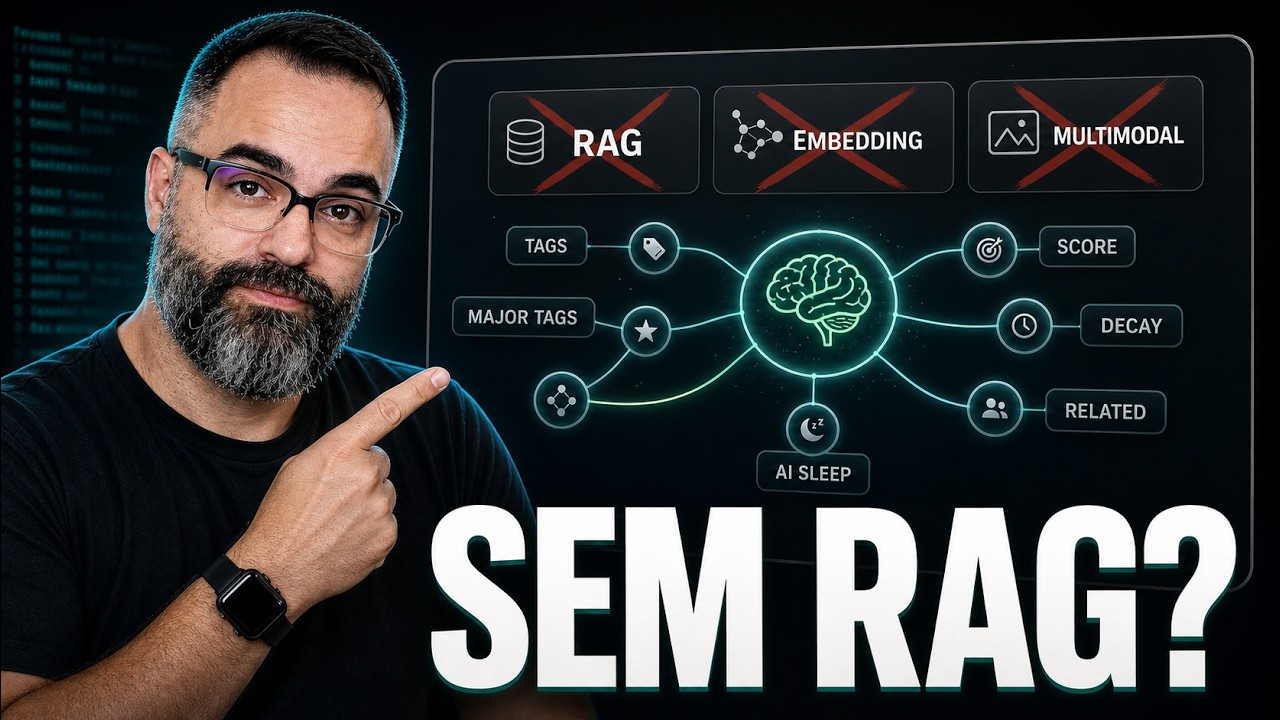
No devlog do Synchron Brain Model, o autor descreve exatamente o caminho inverso: cortar quatro componentes comuns em uma semana de desenvolvimento e substituir por uma abordagem mais barata, previsível e controlável. O resultado é um sistema de memória plug-and-play para IA com decisões explícitas sobre custo, latência e qualidade de busca.
Por que cortar RAG e embeddings logo no começo
O objetivo do Synchron Brain Model não é “ter RAG e pronto”, e sim construir uma camada de memória que funcione como um produto: modular, com comportamento consistente e custo sob controle. Para isso, quatro cortes foram decisivos.
- Processamento multimodal: não é um problema de memória. Se o modelo que pluga na memória não resolve multimodalidade, a memória não vai consertar. O foco do projeto ficou no que realmente é responsabilidade da camada de memória.
- Embeddings e banco vetorial: o autor aponta dois limites práticos: custo de processamento e limites que a própria Pinecone admite. Em vez de depender de uma infraestrutura vetorial para tudo, a memória passa a usar estrutura e heurísticas.
- RAG: a busca semântica completa via RAG ficou desnecessária porque o sistema usa tag e major tag. Na prática, isso reduz chamadas caras ao LLM e evita o “empacotamento” de busca semântica quando a organização já resolve.
- Sinopse comprimida: o projeto mantém sinopses mesmo contra uma recomendação comum em estudos de “AI Engineer”. A justificativa é operacional: o sistema precisa de uma forma compacta de representar memórias para filtrar rapidamente, antes de chegar na memória completa.
O ponto central é que cada componente foi removido por um motivo concreto: custo, limites técnicos ou redundância com mecanismos internos (como tags). Isso muda o desenho do sistema: em vez de “buscar por similaridade”, a memória passa a “filtrar por estrutura e contexto”.
O que está rodando hoje: memória em .md, score e pipeline de filtros
Em vez de depender de um banco vetorial, o Synchron Brain Model armazena cada memória como um arquivo .md com campos bem definidos. Isso não é apenas organização: é controle de comportamento, rastreabilidade e facilidade de inspeção.
O formato inclui:
- ID
- major tags
- score
- data de criação
- último acesso
- contagem de acessos
- ponderação por emoção
- Go Deeper (memórias relacionadas)
O comportamento de busca é guiado por um pipeline de 4 filtros do mais barato ao mais caro. Isso é crucial para automação empresarial: você reduz latência e gasto com LLM mantendo um caminho claro de execução.
- 1º filtro: major tag
- 2º filtro: tag
- 3º filtro: sinopse
- 4º filtro: memória completa
O sistema também introduz decaimento de pontuação. Cada memória nasce com 100 pontos e envelhece com o tempo. Esse mecanismo evita que o modelo “prefira” sempre o que foi armazenado primeiro, mesmo quando o contexto atual não combina.
Além disso, o autor deixa claro que o projeto é compatível com múltiplos provedores de LLM. Para B2B, isso importa porque reduz vendor lock-in e facilita ajustes quando custos e limites mudam.
Do lado operacional, já existem 7 tools no MCP funcionando:
- Remember
- ListMajorTags
- ListTags
- ReadMemory
- Search
- SleepNow
- Stats
Em termos práticos, isso significa que a memória não é um “repositório passivo”. Ela tem operações explícitas para listar categorias, buscar, ler conteúdos e até pausar o processamento (SleepNow). Esse tipo de interface é o que transforma um protótipo em uma peça reutilizável em fluxos de automação.
Sinopse comprimida: por que o autor manteve mesmo contra recomendações
Um dos cortes mais interessantes é o quarto: sinopse x truncamento. O autor menciona um estudo do “AI Engineer” que tende a contrariar essa escolha, mas decide manter sinopses mesmo assim.
A diferença prática entre sinopse e truncamento é que sinopse é uma representação intencional, feita para preservar o que importa para o filtro e para a decisão seguinte. Truncar, por outro lado, é cortar o texto mantendo-o “como está”, o que costuma piorar a qualidade do filtro quando o conteúdo cresce.
Como o pipeline do Synchron Brain Model é sequencial (major tag → tag → sinopse → memória completa), a sinopse atua como uma “ponte” entre o que a estrutura já sabe (tags) e o que só o conteúdo inteiro confirmaria. Em ambientes com custo de LLM, esse desenho reduz chamadas desnecessárias.
Exemplo prático: imagine que o sistema armazene memórias de atendimento, decisões e aprendizados. A major tag pode indicar o domínio (por exemplo, “Financeiro”), a tag pode indicar o tipo (por exemplo, “Regras de cobrança”), e a sinopse resume o caso. Só depois, quando a sinopse for relevante, o pipeline chega na memória completa. Esse fluxo diminui o número de vezes em que o sistema precisa “ler tudo” com um modelo caro.
O autor também inclui Go Deeper, que representa memórias relacionadas. Isso permite que a memória não seja apenas linear: ela pode sugerir profundidade, criando caminhos de contexto sem precisar de busca vetorial semântica.
Próxima versão: “sono”, heurística e refinamento do score por emoção
Para a próxima versão, o Synchron Brain Model vai ganhar um mecanismo de reorganização interna descrito como “sono”. A ideia é que a IA, em períodos definidos, faça tarefas que melhoram a qualidade do sistema sem interromper o fluxo principal.
O plano inclui:
- Construção do “sono”: durante o sono, a IA reorganiza memórias, escreve sinopses e cria “Go Deeper”.
- Busca por heurística antes de chamar a LLM: mais barato primeiro. A heurística reduz chamadas ao modelo quando a estrutura já resolve.
- Cron para disparar o sono automaticamente: em vez de depender de intervenção manual.
- Refinar a ponderação por emoção no score: ajustar como o score evolui com o contexto emocional associado às memórias.
Para quem está construindo automação com IA, isso é um avanço direto em governança: você passa a controlar quando o sistema “pensa” (sono) e quando ele “executa” (pipeline de filtros). Esse controle é o que evita o problema comum de “escopo escapando” e de comportamentos imprevisíveis em fluxos longos com LLM.
O autor também promete explicar a diferença entre desenvolvimento assistido por IA e vibe coding, além de dois comportamentos específicos da IA que precisam ser controlados ao construir sistemas desse tipo. Em projetos B2B, isso geralmente se traduz em risco de custo (mais tokens, mais iterações) e risco de qualidade (mudanças que parecem pequenas, mas alteram arquitetura).
O mais importante é que o Synchron Brain Model está sendo construído com decisões explícitas: o sistema sabe o que filtrar, em que ordem, quando chamar o LLM e como envelhecer memórias com base em score, acesso e emoção.
Para mais detalhes sobre os quatro cortes, o pipeline em funcionamento e o que vem no “sono”, assista ao vídeo completo.
Sua empresa pode ir mais longe com inteligência artificial.
Na Sincron IA, criamos soluções sob medida em automação e IA para empresas que querem liderar seus mercados.
Vamos conversar → sincronia.digital
Receba insights de automação e IA
Conteúdo exclusivo sobre automação empresarial, inteligência artificial e produtividade. Sem spam.

